El procesador se estaba convirtiendo en el freno de mano del acelerador gráfico. Mientras la industria de semiconductores corría a empaquetar decenas de chiplets en un mismo sustrato para inflar el conteo de núcleos, el trabajo con modelos de inteligencia artificial agéntica acaba de chocar contra una pared de latencia inaceptable. La respuesta técnica de NVIDIA no es sumar más bloques de silicio separados, sino hacer exactamente lo contrario: regresar al diseño monolítico con su futura arquitectura CPU Vera.
Y el movimiento no es caprichoso.
Los flujos de trabajo basados en agentes autónomos exigen ciclos de razonamiento secuencial donde la potencia mono-núcleo (Single-Threaded IPC) vuelve a ser la reina absoluta. Cuando un modelo necesita tomar decisiones paso a paso antes de lanzar una tarea masiva a la GPU, la latencia de interconexión entre varios chiplets provoca vacíos de procesamiento donde el silicio gráfico queda congelado esperando instrucciones.
El regreso al die monolítico: arquitectura y silicio sin intermediarios
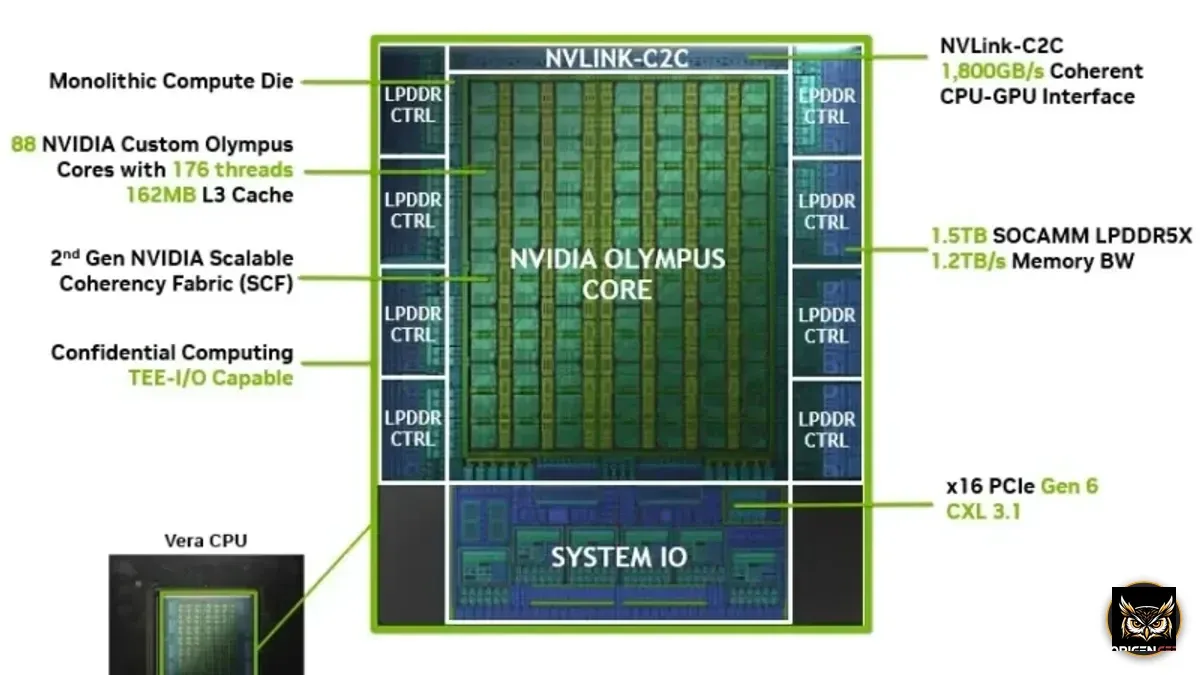
Para erradicar la penalización en milisegundos que impone el tráfico de datos entre pequeñas pastillas de silicio (dies), Vera consolida toda la unidad de cómputo en un único bloque monolítico masivo. Este enfoque elimina de raíz las estructuras de empaquetado intermedio que competidores como AMD e Intel venían utilizando para escalar la cantidad bruta de núcleos a menor costo de fabricación.
Acompañando a esta matriz unificada, el equipo de diseño integró una subunidad de memoria LPDDR5X personalizada y ajustada para ofrecer anchos de banda masivos con consumos controlados. El sistema se enlaza directamente mediante la segunda generación de NVIDIA Scalable Coherent Fabric, un bus coherente que garantiza que cada núcleo acceda a las instrucciones de manera inmediata, manteniendo a la GPU alimentada sin pausas en el procesamiento.
| Especificación Técnica | Arquitectura NVIDIA Vera (Monolítica) | Diseño Basado en Chiplets (Previo / Competencia) | Impacto / Diferencia Directa |
|---|---|---|---|
| Topología de Die | Monolítico de alta densidad | Multi-Die / Chiplets acoplados | Elimina la latencia de interconexión física entre matrices. |
| Enfoque de Cómputo | Balance entre IPC monohilo elevado y throughput | Máxima densidad de núcleos y rendimiento multihilo | Evita cuellos de botella en ejecuciones secuenciales. |
| Subsistema de Memoria | LPDDR5X personalizada de alto ancho de banda | DDR5 multicanal estándar / HBM | Reduce latencias de acceso y optimiza la eficiencia energética. |
| Interconexión Interna | Scalable Coherent Fabric (2da Gen) | Interconnects tipo IF / Ultra Path Interconnect | Mantiene coherencia de caché a velocidad nativa de la matriz. |
| Carga Objetivo | Razonamiento agéntico y bucles en cadena de IA | Renderizado masivo y servidores web paralelos | Mantiene la GPU alimentada al 100% sin esperas en vacíos. |
Cadenas de razonamiento en tiempo real: por qué el multinúcleo masivo falló
El problema con la IA agéntica no es la capacidad de procesar miles de datos al mismo tiempo, sino la velocidad para procesar el dato siguiente que depende estrictamente del anterior. Si una arquitectura sacrifica la frecuencia y el rendimiento por núcleo individual para empaquetar 128 o 192 núcleos en varios chiplets, las llamadas al sistema se ralentizan.
Cada vez que el hilo principal debe cruzar el puente físico de interconexión entre un chiplet y otro para consultar la caché o la memoria compartida, se pierden ciclos de reloj valiosos.
¿El resultado en un entorno de producción real? Una GPU de última generación esperando con un porcentaje de utilización caído a cero durante microsegundos críticos. Al multiplicar esto por millones de iteraciones de código generado por IA o decisiones en tiempo real, el rendimiento global cae estrepitosamente. Vera busca resolver este problema entregando un salto masivo en ejecuciones monohilo sin renunciar a la capacidad de procesamiento multihilo requerida por los centros de datos modernos.
Dictamen Técnico: La decisión de NVIDIA de volver al silicio monolítico demuestra que inflar el conteo de núcleos mediante chiplets no era la solución definitiva. Para la IA agéntica y las cargas con alta dependencia secuencial, la latencia es el enemigo número uno. El costo de fabricación de un die monolítico gigante será astronómico, pero si logra mantener las GPUs trabajando a su máxima capacidad sin tiempos muertos, el mercado empresarial pagará con gusto la diferencia.
Las reglas del juego en el diseño de microprocesadores acaban de cambiar radicalmente. La carrera ya no es ver quién empaqueta más piezas en un circuito impreso, sino quién logra la menor latencia absoluta para que la inteligencia artificial no tenga que detenerse a pensar.