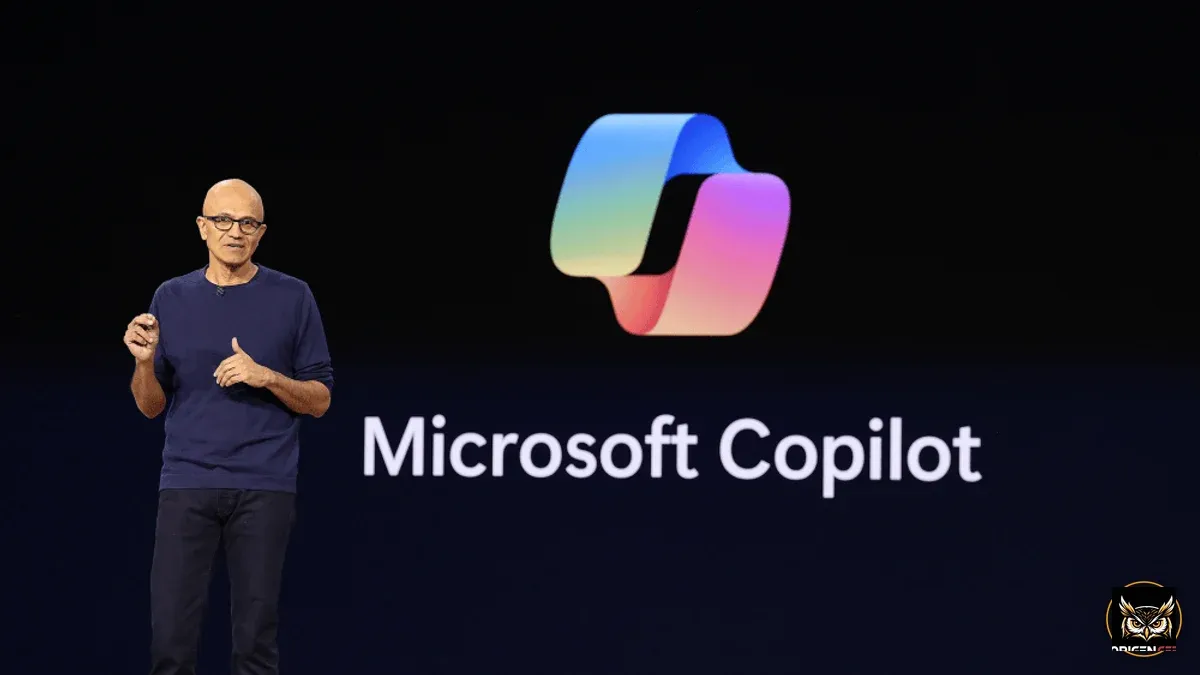
El despliegue acelerado de modelos masivos de inteligencia artificial en infraestructura empresarial expone una brecha operativa crítica: la ausencia de mecanismos estandarizados de interrupción determinista. Satya Nadella, director ejecutivo de Microsoft, señaló públicamente la necesidad de integrar un «freno de emergencia» (emergency brake) en los sistemas de IA, instando a la industria tecnológica a detenerse momentáneamente para evaluar a fondo lo que denominó la «arquitectura de confianza» de estos entornos autónomos.
La advertencia no surge en un vacío teórico. A medida que agentes de software y pipelines neuronales obtienen privilegios de lectura, ejecución y modificación directa sobre bases de datos corporativas y sistemas operativos, la falta de controles de detención a bajo nivel representa un riesgo sistémico latente para infraestructuras críticas.
Vector de Ataque y Vulnerabilidades en la Arquitectura de Confianza
En términos de seguridad informática, los modelos de lenguaje actuales y los agentes autónomos operan sobre esquemas probabilísticos que carecen de aislamiento estricto de privilegios. Las vulnerabilidades más severas no se limitan a la denegación de servicio (DDoS) tradicional, sino a vectores específicos como la inyección indirecta de prompts, la manipulación de contexto en memoria y la ejecución no supervisada de llamadas a funciones (tool-calling) a través de APIs desprotegidas.
Cuando un modelo procesa entradas externas no sanitizadas, el vector de ataque puede forzar al sistema a evadir sus capas de alineación por software (RLHF). En entornos donde la IA interactúa con tokens de autenticación OAuth o credenciales maestras para automatizar tareas, un comportamiento anómalo o manipulado puede desencadenar exfiltración de registros, alteración de configuraciones en la nube o propagación lateral en redes corporativas sin que exista una señal de interrupción centralizada.
El problema central radica en que las salvaguardas actuales son principalmente filtros semánticos a nivel de capa de aplicación, en lugar de barreras de contención deterministas en el runtime de ejecución. La arquitectura de confianza actual confía en que el propio modelo autorregule su comportamiento frente a instrucciones maliciosas, una premisa insostenible desde los fundamentos del modelo Zero Trust.
Alcance, Medidas de Mitigación y el Concepto del Freno de Emergencia
La propuesta conceptual de un freno de emergencia busca trasladar los principios de mitigación física e industrial al software de inferencia. Si bien la dirección ejecutiva de Microsoft no desglosó especificaciones técnicas de ingeniería, estándares de protocolo ni cronogramas de implementación regulatoria para esta herramienta, la discusión técnica apunta a la necesidad de implementar mecanismos de corte estricto que operen fuera del alcance cognitivo del modelo.
Para que un mecanismo de esta naturaleza sea efectivo en infraestructura de producción, debe contemplar capas de intervención comprobables:
- Desconexión Determinista de APIs: Capacidad de revocar tokens de sesión, credenciales efímeras y acceso a herramientas externas de forma instantánea ante anomalías de telemetría.
- Sandboxing y Aislamiento de Memoria: Ejecución de agentes en contenedores aislados con políticas de mínimos privilegios por defecto (least privilege).
- Monitoreo Criptográfico Fuera de Banda: Auditoría de flujos de salida independiente que no dependa de la evaluación del propio modelo para detectar violaciones de políticas.
El alcance de esta reflexión exige que los proveedores de cómputo en la nube y plataformas de modelos fundacionales definan umbrales claros de contención. En Origen Geek sostenemos que la velocidad de adopción comercial no puede supeditar la resiliencia técnica de los entornos corporativos.
Veredicto Técnico: Un modelo de IA conectado a sistemas de producción sin un mecanismo físico o lógico de desconexión inmediata no es una solución automatizada; es un vector de riesgo no mitigado. La seguridad de la infraestructura digital exige que los frenos de emergencia sean auditables, externos y completamente independientes de la lógica probabilística del propio modelo.